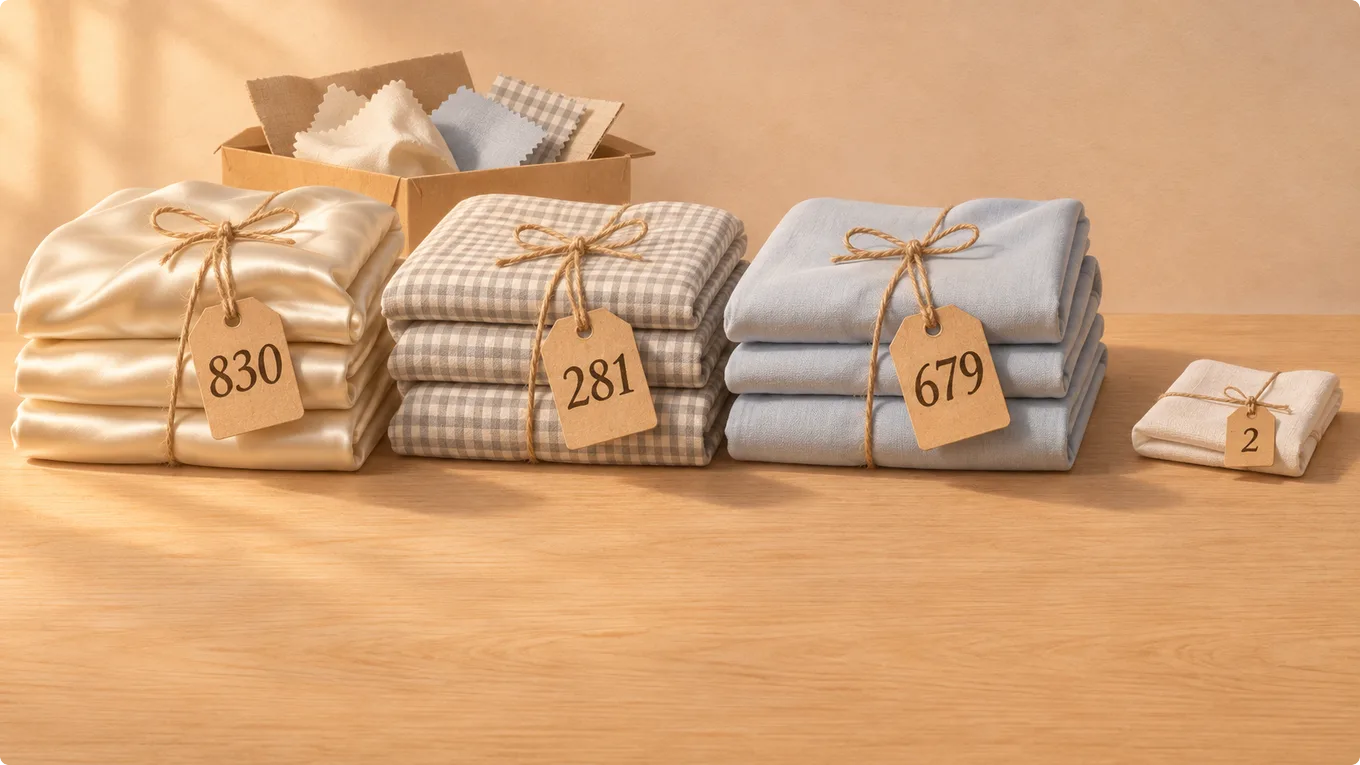
Семантическое ядро для интернет-магазина собирают таблицей, где у каждого запроса стоят частота и тип страницы, которая на него отвечает, и ниже лежит такая таблица для магазина постельного белья на живых частотах Вордстата. Решает в ней последняя колонка, потому что запрос с хорошей частотой без своей страницы уводит покупателя к соседу. Страница под фильтр, которого никто не ищет, только отнимает время у поискового робота.
Ниже покажу, как читать такую таблицу и собрать её самому из прайса и бесплатных сервисов Яндекса. Сверх этого покажу, как превратить ядро в деньги: какие вопросы задать себе по своему каталогу, как на них ответить и как отвечать дальше быстрее с нейросетью.
Пример ядра магазина постельного белья
Больше трети показов в этой таблице ищут совет, а не товар, и магазин без статей отдаёт их чужим сайтам. Частоты сняты в Вордстате по России за тридцать дней до 9 ноября 2026 года, в кавычках, то есть без запросов с дополнительными словами.
| Запрос | Показов в месяц | Какая страница отвечает |
|---|---|---|
| постельное белье купить | 2 571 | корневая категория каталога |
| размеры постельного белья | 2 576 | статья-справочник |
| постельное белье сатин | 830 | подкатегория по ткани |
| постельное белье евро | 679 | подкатегория по размеру |
| постельное белье детское | 562 | отдельная категория |
| постельное белье семейное | 374 | подкатегория по размеру |
| сатин или бязь что лучше | 299 | статья-сравнение |
| постельное белье бязь | 281 | подкатегория по ткани |
| как выбрать постельное белье | 241 | статья |
| постельное белье 1.5 спальное | 202 | подкатегория по размеру |
| постельное белье белое | 116 | страница фильтра по цвету |
| постельное белье бязь 2 спальное | 32 | фильтр, страница при ассортименте |
| постельное белье недорого | 30 | тег в блоке быстрых ссылок |
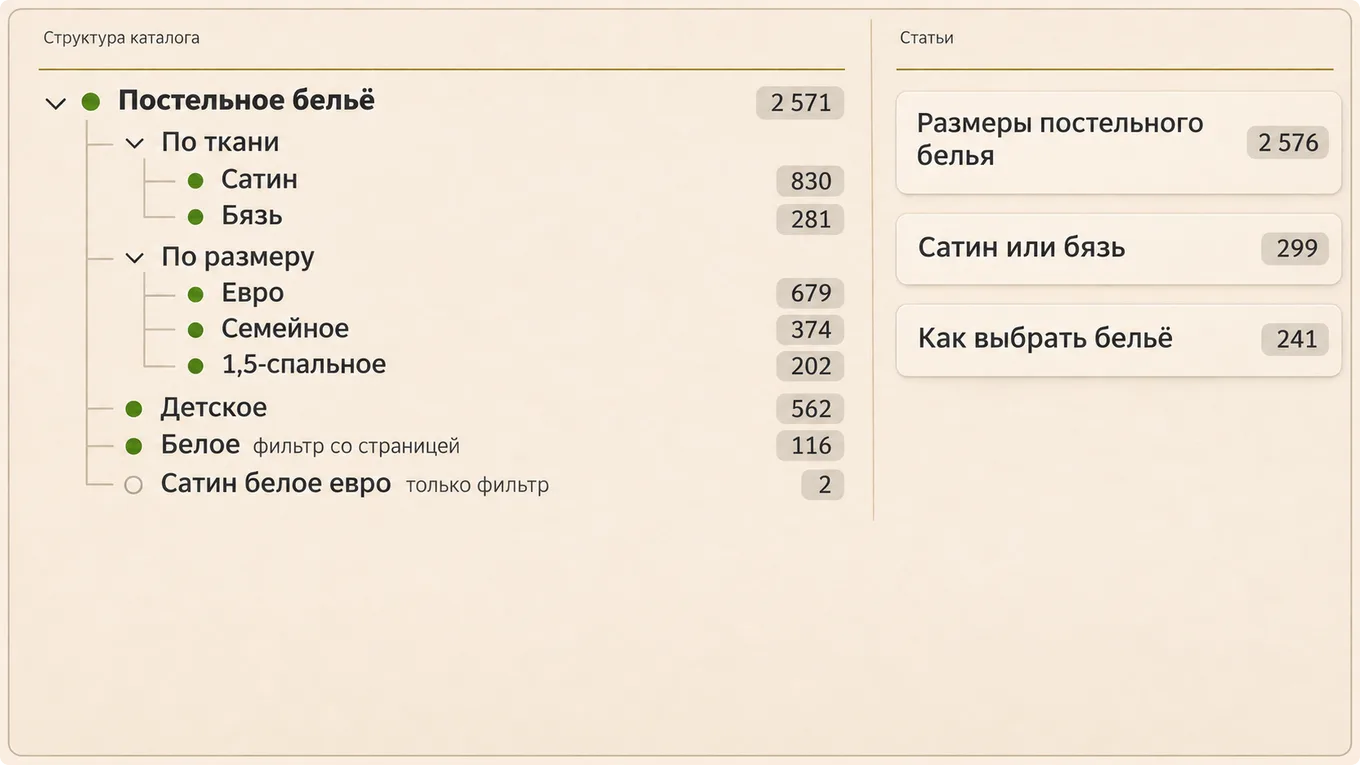
| постельное белье сатин белое евро | 2 | фильтр без своей страницы |
Размеры белья ищут чаще, чем «постельное белье купить» (2 576 показов против 2 571), а справочник по размерам, по моим наблюдениям, магазины чаще прячут таблицей мелким шрифтом в карточке товара. Три вопроса из таблицы дают 3 116 показов из 8 795, это 35 %.
Одну фразу я в таблицу не взял. У «постельное белье сатин евро» точная формулировка собирает половину показов, 3 366 из 6 650, у соседних фраз от 2 до 4 %, и такое число сначала проверяют динамикой.
Какая страница нужна запросу: категория, фильтр, тег или статья
Тип страницы решает больше частоты, потому что один и тот же спрос можно принять в каталог, а можно размазать по сотне одинаковых страниц.
- Категория отвечает на группу товаров, которую покупатель называет одним словом, например детское бельё или евро.
- Страница фильтра нужна сочетанию товара с признаком, если спроса хватает на отдельную страницу и товар есть в наличии.
- Тег собирает размытый признак вроде «недорого» или «в подарок»: в дереве каталога ему места нет, и он живёт блоком быстрых ссылок.
- Статья отвечает на вопрос, после которого человек ещё выбирает.
Почему не делать страницу под каждый фильтр
Собственник хочет больше страниц, ведь каждая кажется лишним входом из поиска, а получает робота, который ходит по мусору. По моему опыту, магазины чаще ошибаются именно так: движок сайта умеет перемножать фильтры, и в индексе оказываются тысячи адресов вроде «сатин белое евро» с двумя показами в месяц. Gary Illyes из Google называл навигацию по сочетаниям фильтров источником половины проблем с обходом сайтов за 2025 год (Search Engine Roundtable).
Противоречие снимает само ядро. Где спроса хватает, чтобы страница оправдала товар и текст, она появляется, а при двух показах в месяц фильтр остаётся кнопкой.
Как собрать ядро магазина самому
Ядро магазина собирается из того, что у него уже лежит готовым, то есть из прайса, фильтров каталога и двух бесплатных сервисов Яндекса.
Откуда брать запросы
Начинают с прайса и выписывают товары и признаки, по которым покупатель выбирает: ткань, размер, цвет, производителя. Каждое сочетание «товар плюс признак» проверяют в Вордстате и смотрят частоту в кавычках, потому что этот оператор, по справке Директа, фиксирует число слов и отсекает чужие хвосты. Чистка топа от мусора разобрана в статье про Вордстат Яндекс Директ и подбор слов.
Второй сервис, «Подбор поисковых запросов» в Вебмастере, показывает сотни миллионов запросов со спросом и конкурентностью, данные усреднены за прошлый год (справка Вебмастера). Там же по списку до 50 адресов своего сайта видно, по каким запросам каждая страница появлялась в поиске за месяц.
Что вычеркнуть и куда отнести запрос
В топе Вордстата по «постельному белью» стоят «озон постельное белье» (11 501 показ) и «стирка постельного белья» (9 336). Первая ищет маркетплейс, вторая совет по уходу, и каталог магазина не нужен ни той, ни другой. Маркетплейсы и бренды, которых магазин не продаёт, вычёркивают сразу, вопросы откладывают в план статей.
В одном техзадании магазина на полмиллиона товаров хотели «продвигаться как точечно по товарам, так и по категориям, брендам и моделям». Ядро как раз отвечает, какому из этих уровней нужна своя страница. Саму сборку и разметку ядра для каталога можно отдать подрядчику, а себе оставить сверку с ассортиментом: только магазин знает, каких товаров на складе нет.
Что ядро меняет в заказах магазина
Короткий список ключей в отчёте подрядчика почти всегда закрывает малую долю спроса, и видно это только по ядру.
В интернет-магазине домашнего текстиля на три тысячи позиций* это выглядело так. Подрядчик вёл 25 ключей, 15 из них стояли в первой десятке Яндекса, а заказов из поиска приходило 11 в месяц. Когда собрали весь спрос по ассортименту, около 9 000 показов в месяц, оказалось, что ключи договора закрывают 10 % поисков, а большую часть остального ищут товаром с признаком: тканью, размером, цветом.
Магазин сделал 14 страниц под сочетания со спросом и 12 статей за три месяца. Число запросов, по которым его видно в поиске, выросло со 140 до 1 100, в 7,9 раза, а заказов из поиска стало 30 в месяц вместо 11. Заказы держатся ещё и на том, как сайт превращает визиты в покупки, это конверсия сайта без роста рекламного бюджета. Проверить, какую долю спроса закрывают ключи договора, стоит до его продления.
Где нейросеть ускоряет ядро, а где ошибается
Нейросеть хорошо делает скучную часть ядра и плохо делает ту, где нужны числа. Я бы отдал ей разметку: тысячу запросов она разложит по типам страниц за минуты, найдёт маркетплейсы, чужие бренды и информационные хвосты.
Опасна она в другом. Частоты нейросеть придумывает уверенно и правдоподобно, поэтому числа в ядро идут только из Вордстата или Вебмастера, а модель получает их готовыми. Модель без доступа к поиску не видит и выдачу Яндекса, то есть не знает, что на запрос показывают сейчас, каталоги или статьи.
Собственник сам решает, какие сочетания магазин закроет товаром и какие страницы делать первыми под маржу. Если разметку некому сверить с каталогом и выдачей, довести ядро до структуры сайта проще вместе с тем, кто будет эти страницы продвигать.
Промпт: распределить запросы магазина по типам страниц
Подойдёт любая крупная модель: DeepSeek работает бесплатно и без VPN, ChatGPT и Claude мощнее, но с ограничениями доступа из России. Перед вставкой замените название магазина и брендов метками, персональные данные и коммерческую тайну в публичный чат не вставляйте.
Ты SEO-аналитик интернет-магазина. Разложи запросы по типам страниц и покажи, какую долю спроса магазин сейчас не принимает.

Что нужно на выходе: таблица «запрос, показов в месяц, тип страницы, есть ли такая страница на сайте» и три числа про мой магазин: доля показов без своей страницы, доля показов на статьи, число фильтров каталога, по которым в моих данных нет ни одного запроса.

Зачем: понять, какие страницы сделать первыми, а какие фильтры закрыть от поиска.

Данные ниже: выгрузка запросов из Вордстата или Вебмастера с частотой, список категорий и фильтров моего каталога, адреса сайта с заголовками страниц.

Иди строго по порядку и не переходи к следующему шагу, пока не закончен предыдущий:
1. Вычеркни запросы с маркетплейсами и брендами, которых нет в моём каталоге, покажи список вычеркнутых.
2. Каждому оставшемуся запросу поставь тип: категория, страница фильтра, тег, статья.
3. Сверь с моими адресами и заголовками, у каких запросов своей страницы нет, сомнительные совпадения отметь для проверки.
4. Посчитай три числа из раздела «что нужно на выходе», с формулой.
5. Назови 10 страниц, которые я бы сделал первыми, по сумме показов.
6. Под каждой находкой дай фразу, которую я отправлю подрядчику или программисту завтра.

Нюансы: пиши простым языком. Если запрос подходит к двум типам, выбери один и объясни одной фразой. Если в моих данных нет частоты, не подставляй её, а так и напиши. Фильтры, которых нет в выгрузке, отметь «не проверено»: это не значит, что спроса нет.

Рамки: частот и запросов не выдумывай, считай только по моим данным. Мотивационные речи и рассуждения о важности опусти полностью.
Коротко: главное из статьи
- Семантическое ядро магазина собирают таблицей, где у каждого запроса указаны частота и тип страницы.
- В учебном ядре постельного белья вопросы дают 35 % показов, 3 116 из 8 795.
- Страницу фильтра заводят, когда спроса хватает на отдельную страницу и товар есть в наличии.
- Частоты берут из Вордстата в кавычках и из Вебмастера, маркетплейсы и бренды не из каталога вычёркивают.
- Нейросеть размечает запросы быстро, но частоты в ядро идут только из сервисов Яндекса.
Частые вопросы
Сколько запросов должно быть в ядре интернет-магазина?
Нормы нет, число задаёт ассортимент. Магазину с одной товарной группой хватает нескольких сотен фраз, крупному каталогу нужны десятки тысяч. Проверка простая: у каждой категории и у каждого фильтра со спросом в ядре есть хотя бы один запрос, а у каждого запроса есть страница или пометка, почему её не будет.
Нужно ли делать отдельную страницу под каждый фильтр каталога?
Нет, только под сочетания, где спроса хватает на отдельную страницу и товар есть в наличии. В примере магазина белья «постельное белье бязь 2 спальное» собирает 32 показа в месяц, а «сатин белое евро» всего два, и второму своя страница не нужна. Остальные фильтры работают кнопками. Для их адресов справка Яндекса о дублях называет canonical с основным адресом, запрет обхода в robots.txt и noindex.
Можно ли собрать семантическое ядро для интернет-магазина бесплатно?
Да, для небольшого каталога хватает бесплатных сервисов Яндекса. Вордстат даёт частоты фраз в кавычках, а «Подбор поисковых запросов» в Вебмастере показывает спрос, конкурентность и запросы, по которым уже появляются страницы сайта. Платные программы экономят время на больших каталогах, где запросов десятки тысяч и вручную их не разобрать.
Как часто нужно обновлять ядро магазина?
Ядро обновляют, когда меняется ассортимент: новая товарная группа, новый признак в фильтрах, уход старого бренда. Для сезонных товаров частоты полезно сверять перед сезоном, потому что спрос на одни и те же фразы меняется по месяцам. Учтите и задержку данных: по справке Вебмастера, в Вордстате она может доходить примерно до месяца.
* Проект под NDA, поэтому компания здесь не названа.