Локальная LLM модель, нейросеть для работы с текстом, работает на компьютере или сервере самой компании, поэтому договоры, переписка с клиентами и выгрузки из учёта не уходят за пределы её сети. Запустить у себя можно только модели с открытыми весами, то есть с выложенным файлом, и среди них gpt-oss от OpenAI, Qwen3 от Alibaba, GigaChat 3 Lightning от Сбера и YandexGPT 5 Lite от Яндекса. Лицензии gpt-oss, Qwen3 и GigaChat бесплатны и для компании, у YandexGPT 5 Lite бесплатный объём ограничен, а платят в основном за железо.
Сервер с видеокартой RTX 4090 у Selectel стоит от 56 900 рублей в месяц, а та же gpt-oss-20b через API Yandex AI Studio, подключение программы к облачной модели, стоит 0,1 рубля за тысячу токенов (кусочков текста). Поэтому свою модель чаще ставят ради данных, чем ради экономии.
Разберу, какую модель выбрать, сколько памяти ей нужно и когда свой сервер выгоднее облака. Сверх этого покажу, как превратить выбор в деньги, какие вопросы задать себе до аренды железа, как ответить на них по своим задачам и как пересчитывать решение за минуты, отдав часть работы нейросети.
Лучшие локальные LLM модели для компании в 2026 году
Лучшую модель здесь выбирают по лицензии и размеру, а рейтинги качества смотрят третьими. Модель, которая не помещается в память, бесполезна при любых баллах.
| Модель | Разработчик | Лицензия | Параметров, млрд | Файл в Ollama |
|---|---|---|---|---|
| Qwen3 8B | Alibaba | Apache 2.0 | 8,2 | 5,2 ГБ |
| gpt-oss-20b | OpenAI | Apache 2.0 | 21, активных 3,6 | 14 ГБ |
| GigaChat 3 Lightning | Сбер | MIT | 10, активных 1,8 | нет данных |
| YandexGPT 5 Lite | Яндекс | своя, до 10 млн выходных токенов в месяц | 8 | нет данных |
| gpt-oss-120b | OpenAI | Apache 2.0 | 117, активных 5,1 | 65 ГБ |
| DeepSeek V3 | DeepSeek | своя, коммерция разрешена | 671, активных 37 | 404 ГБ |
Источники: карточки моделей на Hugging Face и библиотека Ollama со сжатыми сборками.
Для русских текстов я бы сравнил на своих документах GigaChat и YandexGPT с Qwen3. Лицензию читаю до установки (у YandexGPT 5 Lite в ней сидит сюрприз). Внутренние нужды компании она тоже считает коммерцией и бесплатно разрешает до 10 миллионов выходных токенов в месяц. Облачный ГигаЧат разобран в статье про ГигаЧат для бизнеса.
Программа на компьютере и сама модель живут в разных местах
Приложение ChatGPT или Claude на рабочем столе ещё не делает модель локальной. По моему опыту, это самая частая путаница, и после установки собственник спрашивает, нужны ли теперь VPN и подписка. Нужны, ведь приложение служит окном, через которое вопрос уходит на серверы разработчика. Закрытые модели вроде Claude и флагманов ChatGPT не выкладывают вовсе, их только арендуют по подписке или за токены.
Даже открытая модель уровня флагмана требует серверной. Файл DeepSeek V3 в Ollama весит около 404 ГБ, а видеокарта H200 держит 141 ГБ, так что под одни веса нужны минимум три карты. Восемь H200 в облаке Selectel стоят от 5 397 рублей в час, около 3,9 миллиона за месяц. Локальной у компании остаётся модель поменьше.
Сколько памяти нужно локальной модели
Модель запускается только тогда, когда её файл целиком помещается в память, оперативную при работе на процессоре или видеопамять при работе на видеокарте. По библиотеке Ollama, Qwen3 8B занимает 5,2 ГБ, gpt-oss-20b 14 ГБ, а gpt-oss-120b 65 ГБ, и старшей, по OpenAI, хватает одной видеокарты на 80 ГБ.
Запас нужен ещё на сам текст. Чем длиннее документ, который модель держит перед глазами, и чем больше сотрудников спрашивают её одновременно, тем больше памяти уходит сверх файла. По умолчанию Ollama даёт модели всего 4 096 токенов контекста, а договор на двадцать страниц в такое окно целиком не влезет.
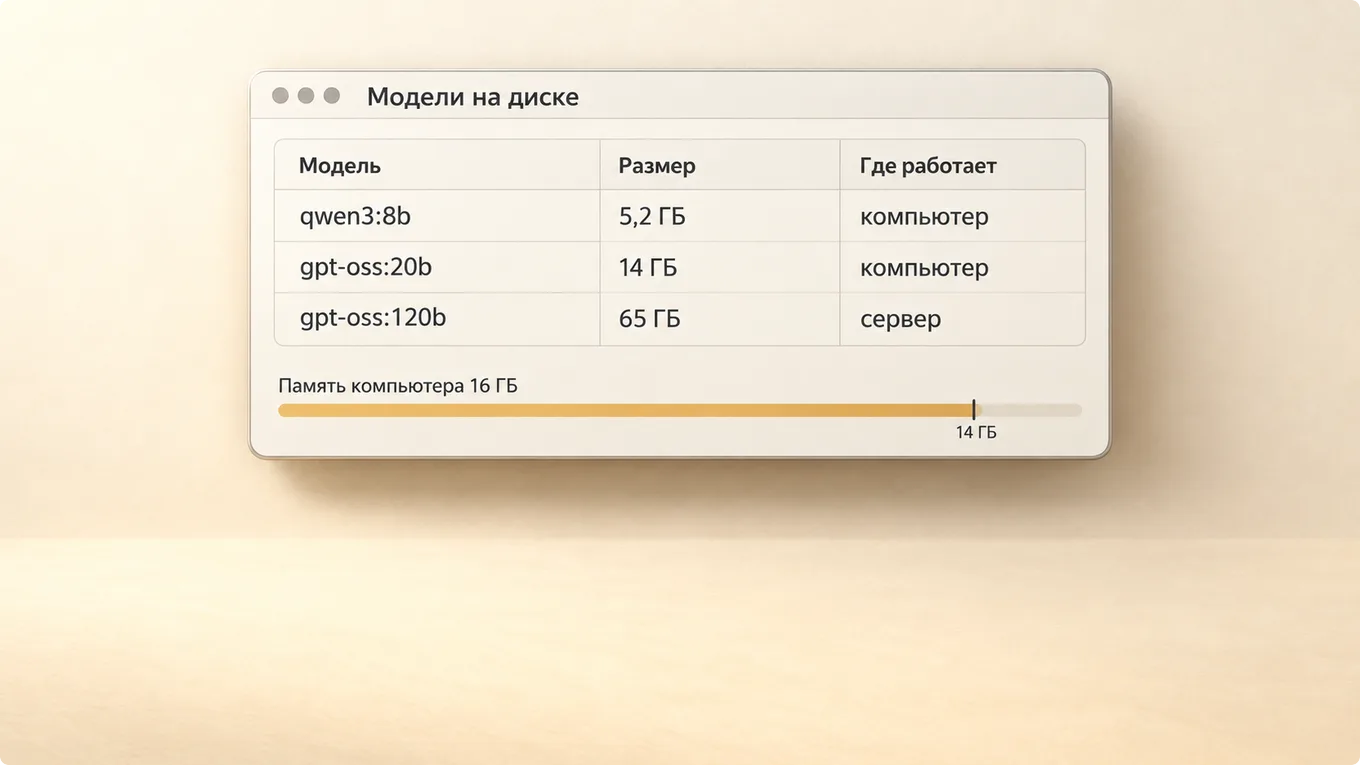
Аренда вместо покупки
Выделенный сервер Selectel с RTX 4090 на 24 ГБ стоит от 56 900 рублей в месяц, с RTX PRO 6000 на 96 ГБ от 225 000, с H200 на 141 ГБ от 415 800, цены с НДС. Для пробы хватит облачного сервера с картой L4 от 69,88 рубля в час, и восемь часов экспериментов обойдутся примерно в 560 рублей. Я бы начинал с такого пробного дня, а о покупке железа говорил после него.
Своя модель дешевле API только на большом потоке
Собственник ставит модель у себя, чтобы перестать платить за каждый токен, и получает счёт, который приходит каждый месяц, даже если модель простаивала. Здесь работает тот же приём, что и с любой тратой на нейросети, и цену своего сервера кладут рядом с альтернативой, а не считают в вакууме.
Учебный расчёт точки равенства
Возьмём одну и ту же gpt-oss-20b. В тарифах Yandex AI Studio она стоит 0,1 рубля за тысячу токенов вопроса и ответа, а сервер с RTX 4090 у Selectel обходится от 56 900 рублей в месяц. Делим одно на другое, и аренда сравнивается с API только на 569 миллионах токенов в месяц. Если страница договора вместе с ответом модели занимает условные 1 500 токенов, выходит около 379 тысяч страниц ежемесячно, а часы специалиста, который держит сервер, сюда ещё не вошли.
Это около 12 600 страниц в день, и такой поток есть у немногих. Цены облачных моделей разобраны в статье про YandexGPT для бизнеса, годовой счёт за готового помощника в разборе сколько стоит ИИ агент.
Настоящая причина ставить модель у себя
Противоречие снимают данные. Закон о персональных данных в части 5 статьи 18 запрещает при сборе записывать и хранить данные граждан России в базах за рубежом, а перед передачей данных за границу статья 12 обязывает заранее уведомить Роскомнадзор. Российское облако первую задачу снимает, но в Yandex AI Studio, например, запросы по умолчанию ложатся в журнал сервиса, пока его не отключат отдельным заголовком.
Своя модель убирает вопрос целиком, особенно там, где сотрудники уже носят клиентские файлы в личные чаты (об этом статья про теневой ИИ). С 1 марта 2027 года по закону № 243-ФЗ Правительство сможет назначать случаи, где допускаются только суверенные и национальные модели, перечня пока нет.
Где своя модель полезна, а где опасна
Своя модель полезна на однообразной работе с чувствительными текстами. Разложить входящие заявки по темам, вытащить из договора стороны, сроки и суммы, составить конспект записи звонка с клиентом. Промах здесь видно на первой сверке, а текст при этом не покидает компанию.
Опасна она там, где нужно рассуждать. Я бы не доверял модели, которая помещается в рабочий компьютер, расчёты и ссылки на нормы закона, ведь пишет она так же уверенно, как облачный флагман, а ошибку заметит только проверяющий. Вторая опасность сидит в самом сервере (его обновляют, за его памятью следят, а упавший ночью сервер кто-то должен поднять к утру).
Три вещи собственник решает сам. Какие тексты не покидают компанию ни при каком раскладе, кто отвечает за сервер и на каком объёме выбор пересматривают. Если подобрать модель и поставить её на сервер компании некому, это часть работы по внедрению нейросетей в процессы компании.
Промпт: нужна ли компании своя модель
На вход нужны задачи, которые вы хотите отдать нейросети, сколько таких документов, писем или звонков проходит в месяц и где в них есть данные клиентов. Всё это вы знаете без подготовки. Названия клиентов и компаний замените метками, персональные данные и коммерческую тайну в публичный чат не вставляйте. Подойдёт любая крупная модель, DeepSeek работает бесплатно и без VPN, ChatGPT и Claude мощнее, но с ограничениями доступа из России.
Роль. Ты аналитик затрат на нейросети и решаешь, ставить ли компании свою модель или платить облаку.

Результат. Таблица по моим задачам: задача, документов в месяц, токенов в месяц, рублей в месяц по API, есть ли персональные данные. Под ней три числа: доля токенов месяца в задачах с персональными данными; во сколько раз аренда сервера дороже или дешевле API на моём объёме; сколько токенов в месяц уравняют сервер с API.

Зачем. Не арендовать простаивающий сервер и не отправить в облако то, что должно остаться в компании.

Цены, других не придумывай. Модель gpt-oss-20b по API Yandex AI Studio стоит 0,1 рубля за 1000 токенов вопроса и ответа. Сервер с видеокартой RTX 4090 в аренде у Selectel стоит от 56 900 рублей в месяц. Цены с НДС на 27 октября 2026 года.

Подзадачи строго по порядку, к следующей не переходи, пока не закрыта предыдущая.
1. Перескажи в двух строках, какие задачи я хочу отдать модели, и спроси, верно ли понял. Без ответа дальше не иди.
2. Оцени токены на один документ каждой задачи, вопрос вместе с ответом. Нет примера документа, дай диапазон и пометь как оценку.
3. Посчитай токены и рубли в месяц по API для каждой задачи и итог.
4. Отметь задачи с персональными данными или коммерческой тайной и посчитай их долю в токенах месяца.
5. Сравни итог API с арендой сервера и назови кратность.
6. Под каждой находкой дай фразу, которую я завтра скажу программисту.

Нюансы. Пиши просто, деньги в рублях. Если число документов противоречит описанию задачи, покажи оба варианта и спроси.

Рамки. Не выдумывай цены, модели и требования закона. Не оценивай качество моделей. Мотивационные речи и рассуждения о важности опусти полностью.
Коротко: главное из статьи
- Локальная LLM модель работает на компьютере или сервере компании, и тексты не уходят за пределы её сети.
- Запустить у себя можно только модели с открытыми весами, например gpt-oss, Qwen3, GigaChat 3 Lightning и YandexGPT 5 Lite.
- Файл модели должен поместиться в память, и Qwen3 8B занимает 5,2 ГБ, а gpt-oss-120b 65 ГБ.
- Сервер с RTX 4090 у Selectel стоит от 56 900 рублей в месяц, gpt-oss-20b по API Yandex AI Studio 0,1 рубля за тысячу токенов.
- Аренда сравнивается с API около 569 миллионов токенов в месяц, поэтому свою модель чаще ставят ради данных.
Частые вопросы
Можно ли запустить ChatGPT у себя на компьютере?
Сам ChatGPT нельзя, OpenAI его модели не выкладывает, и приложение на компьютере только пересылает вопросы на серверы разработчика. Запустить у себя можно открытые модели OpenAI серии gpt-oss под лицензией Apache 2.0. Младшая gpt-oss-20b, по данным разработчика, работает в 16 ГБ памяти, старшая помещается в одну видеокарту на 80 ГБ.
Какой компьютер нужен, чтобы запустить локальную нейросеть?
Файл модели должен целиком поместиться в оперативную память или видеопамять с запасом на текст. По библиотеке Ollama Qwen3 8B занимает 5,2 ГБ, и ей хватит рабочего компьютера с 16 ГБ памяти. Для gpt-oss-120b на 65 ГБ нужна серверная видеокарта, и у Selectel сервер с картой на 96 ГБ стоит от 225 000 рублей в месяц.
Можно ли бесплатно пользоваться YandexGPT Lite в компании?
Открытую версию YandexGPT 5 Lite 8B можно скачать с Hugging Face и запустить у себя. Её лицензия считает коммерческим и использование для внутренних нужд компании и разрешает его до 10 миллионов выходных токенов в месяц. Если порог достигнут, обратиться в Яндекс нужно в течение 30 календарных дней после окончания этого месяца и договориться об условиях, иначе лицензия аннулируется.
Нужно ли уведомлять Роскомнадзор, если модель стоит на своём сервере?
Если сервер с моделью стоит в России и данные клиентов за границу не уходят, трансграничной передачи нет, и уведомление по статье 12 закона о персональных данных не нужно. Остальные обязанности оператора по этому закону остаются за компанией. Отправка тех же данных в облачную модель на зарубежных серверах уже считается передачей за границу.